Infraestrutura & Cloud
Resiliência em infraestrutura: práticas para servidores, backup e virtualização
Entenda como diagnóstico, monitoramento, virtualização planejada e recuperação testada ajudam a reduzir indisponibilidades em ambientes corporativos.
Por Thiago Henrique ·
Uma infraestrutura resiliente não é aquela que nunca apresenta falhas. É aquela que consegue manter serviços essenciais disponíveis ou recuperá-los de forma organizada quando ocorre uma falha de hardware, um problema de desempenho, uma atualização mal sucedida ou um incidente de segurança.
Em muitas empresas, a operação depende de poucos componentes: Active Directory, DNS, servidor de arquivos, banco de dados, ERP, máquinas virtuais, conexão com a internet e cópias de backup. Quando essas dependências não são conhecidas ou documentadas, uma falha aparentemente simples pode interromper atividades de toda a empresa.
Por isso, resiliência não deve ser vista apenas como compra de hardware ou contratação de uma ferramenta. Ela depende de planejamento, administração contínua, monitoramento, testes e procedimentos que façam sentido para o ambiente real.
O que significa ter uma infraestrutura resiliente?
Resiliência é a capacidade de um ambiente suportar falhas e retornar à operação dentro de um tempo aceitável para o negócio.
Isso envolve entender quais serviços são críticos, quem depende deles e qual seria o impacto caso ficassem indisponíveis por algumas horas ou dias. Um servidor pode estar ligado e, ainda assim, não entregar valor para a operação se usuários não conseguem autenticar, acessar arquivos, utilizar o ERP ou consultar dados do banco de dados.
O planejamento de contingência não se resume à restauração de arquivos. O NIST define esse processo como uma combinação de planos, procedimentos e medidas técnicas voltadas à recuperação de sistemas, dados e operações após uma interrupção.
Na prática, uma infraestrutura mais preparada costuma ter:
Serviços críticos identificados;
Inventário de servidores, máquinas virtuais e aplicações;
Monitoramento de recursos e serviços;
Atualizações planejadas;
Backup com retenção e proteção adequada;
Testes de restauração;
Controle de acessos administrativos;
Documentação das dependências;
Procedimentos de contingência conhecidos pela equipe.
O objetivo não é eliminar qualquer possibilidade de falha. O objetivo é reduzir o impacto, evitar decisões improvisadas e tornar a recuperação mais previsível.
Servidores: disponibilidade começa pelo diagnóstico
Quando um sistema fica lento ou indisponível, a primeira reação pode ser atribuir o problema ao servidor. No entanto, a causa pode estar no armazenamento, na rede, no DNS, no banco de dados, na falta de memória, em uma rotina de backup executada no horário errado ou em uma máquina virtual mal dimensionada.
Antes de substituir equipamentos ou migrar serviços, é importante entender onde está o gargalo. No artigo sobre servidor lento ou instável, explicamos como avaliar os sinais mais comuns e diferenciar uma falha pontual de uma necessidade real de revisão da infraestrutura.
Alguns alertas que merecem investigação são:
CPU ou memória em uso elevado de forma recorrente;
Espaço em disco próximo do limite;
Alta latência de leitura e gravação;
Falhas em discos, fontes ou controladoras;
Reinicializações inesperadas;
Alertas de backup sem tratamento;
Lentidão em horários específicos;
Máquinas virtuais disputando recursos no mesmo host;
Serviços que deixam de responder após atualizações;
Falhas de autenticação, DNS ou acesso a compartilhamentos.
A análise de desempenho precisa considerar a carga de trabalho, o hardware e o objetivo de cada servidor. A Microsoft reúne diretrizes de ajuste de desempenho para Windows Server e reforça que alterações de configuração devem ser avaliadas conforme o ambiente, e não aplicadas de forma genérica.
Virtualização ajuda, mas também concentra riscos
A virtualização permite executar diferentes servidores lógicos em um ou mais hosts físicos. É comum separar serviços como Active Directory, servidor de arquivos, ERP, banco de dados e aplicações internas em máquinas virtuais distintas.
Esse modelo pode melhorar o uso dos recursos, facilitar a organização do ambiente e tornar a recuperação mais ágil. Porém, virtualizar não elimina riscos. Em alguns cenários, pode concentrar vários serviços críticos em um único host, armazenamento ou equipamento de rede.
Antes de criar ou migrar máquinas virtuais, vale avaliar:
Capacidade de CPU, memória e armazenamento do host;
Crescimento previsto para os próximos meses;
Uso de overcommit de CPU e memória;
Desempenho do storage e quantidade de IOPS disponível;
Redundância de fontes, interfaces de rede e controladoras;
Separação entre produção, backup e administração;
Estratégia para falha de um host físico;
Licenciamento, suporte e atualização da plataforma;
Dependências entre as máquinas virtuais;
Ordem de inicialização dos serviços após uma indisponibilidade.
A plataforma de virtualização precisa ser dimensionada como um conjunto. A Microsoft recomenda analisar processador, memória, armazenamento e interfaces de rede de forma integrada, pois a falta de desempenho em I/O ou rede pode comprometer o ambiente mesmo quando há CPU disponível.
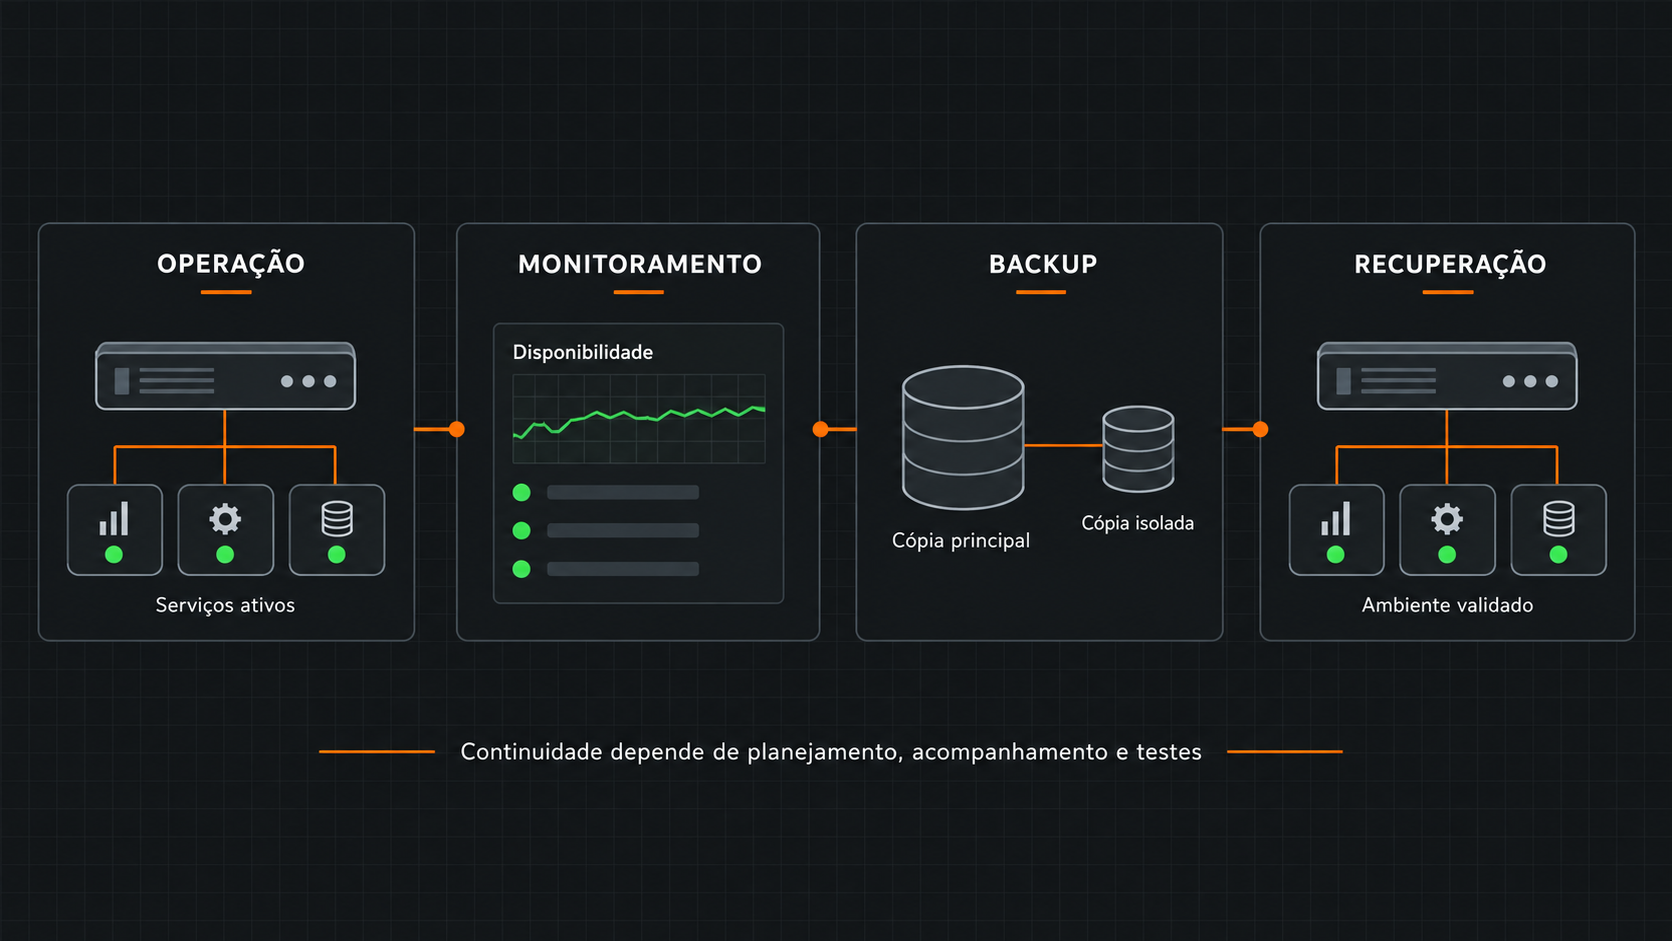
Em um ambiente menor, um único host pode ser suficiente para a operação. Ainda assim, ele deve ser tratado como um ponto único de falha. Nesse caso, a qualidade do backup, a disponibilidade de peças, a documentação e o tempo necessário para restauração tornam-se ainda mais importantes.
Backup: uma cópia não é, por si só, uma recuperação
Um job de backup concluído com sucesso é um bom sinal, mas não encerra a validação. A questão principal é: se um serviço crítico parar agora, a empresa consegue restaurá-lo dentro do tempo que a operação suporta?
A resposta depende de vários fatores:
Quais servidores, dados e configurações estão incluídos;
Com que frequência os pontos de recuperação são criados;
Por quanto tempo as versões são mantidas;
Onde as cópias estão armazenadas;
Quem pode alterar, reduzir retenção ou apagar backups;
Se existe uma cópia separada do ambiente de produção;
Se há proteção contra alteração, exclusão ou ransomware;
Quanto tempo leva para restaurar arquivos, máquinas virtuais e aplicações;
Se a restauração já foi testada.
A CISA recomenda manter backups protegidos e testar regularmente a disponibilidade e a integridade das cópias. A orientação é especialmente relevante porque ataques de ransomware podem tentar localizar, criptografar ou apagar backups acessíveis com as mesmas credenciais do ambiente de produção.
Uma estratégia de backup empresarial precisa considerar mais do que o armazenamento da cópia. Ela deve definir o que será recuperado, de qual ponto no tempo, por quem e em quanto tempo.
Esse cuidado também é essencial para reduzir o impacto de incidentes de segurança. No Insight sobre como proteger uma empresa contra ransomware, detalhamos como backups, segmentação, controle de acessos e monitoramento atuam em conjunto.
RPO e RTO ajudam a definir prioridades
Duas métricas ajudam a transformar a continuidade em decisões práticas: RPO e RTO.
O RPO (Recovery Point Objective) representa quanto de informação a empresa aceita perder. Se o limite for quatro horas, por exemplo, a estratégia de backup precisa oferecer pontos de recuperação compatíveis com esse intervalo.
O RTO (Recovery Time Objective) representa o tempo aceitável para restabelecer um serviço. Recuperar uma cópia em 30 minutos não significa que toda a aplicação estará disponível nesse prazo. Ainda podem existir validações, dependências, permissões, configurações de rede e testes do banco de dados.
Nem todos os serviços precisam voltar ao mesmo tempo. Em uma contingência, uma ordem possível de recuperação pode ser:
Rede, firewall e acesso administrativo;
DNS, Active Directory e autenticação;
Banco de dados e sistemas de gestão;
Servidor de arquivos e integrações;
Serviços auxiliares e aplicações menos críticas.
A priorização deve ser definida junto às áreas que dependem dos sistemas. A TI pode medir o tempo de recuperação, mas as áreas de negócio conhecem melhor o impacto de uma indisponibilidade.
Testar restauração é diferente de confiar no backup
Uma restauração precisa ser testada periodicamente. Um arquivo pode estar presente no repositório, mas falhar ao ser aberto. Uma máquina virtual pode iniciar, mas não conseguir resolver nomes no DNS, acessar o banco de dados ou autenticar usuários.
Os testes devem considerar cenários como:
Restauração de arquivos individuais;
Recuperação de máquinas virtuais;
Recuperação de banco de dados;
Restauração de configurações de rede e firewall;
Validação de credenciais e permissões;
Inicialização de serviços na ordem correta;
Recuperação em host ou local alternativo;
Tempo total até a aplicação voltar a funcionar.
A CISA destaca a importância de testar procedimentos de backup em cenários de recuperação, pois a existência de uma cópia não garante que ela será utilizável quando houver uma falha real.
O resultado de cada teste deve ser registrado. Isso permite identificar ajustes necessários em retenção, capacidade, documentação ou sequência de recuperação antes de um incidente.
Atualizações e mudanças também precisam de plano
Atualizações de sistemas operacionais, hypervisors, drivers, antivírus e aplicações são necessárias para segurança, compatibilidade e estabilidade. Porém, quando são executadas sem planejamento, podem causar indisponibilidade ou conflito com serviços dependentes.
Antes de mudanças relevantes, é recomendável:
Identificar os sistemas e usuários afetados;
Verificar compatibilidade entre aplicação, sistema operacional e plataforma de virtualização;
Definir uma janela de manutenção;
Confirmar a existência de backup válido;
Registrar a configuração atual;
Ter um procedimento de retorno caso a mudança falhe;
Testar os principais serviços após a execução;
Atualizar a documentação do ambiente.
A Microsoft também orienta que decisões de ajuste e desempenho sejam consideradas de acordo com a função do servidor e sua carga de trabalho, evitando alterações isoladas que possam gerar efeitos inesperados no ambiente. Veja as orientações para gerenciamento de servidores Windows.
Monitoramento reduz o tempo entre falha e resposta
Monitorar não significa apenas receber alertas. Um monitoramento útil precisa indicar o que exige ação, quem deve responder e qual impacto aquele evento pode causar.
Em servidores e ambientes virtualizados, alguns indicadores relevantes são:
Uso de CPU, memória e armazenamento;
Latência de disco;
Estado de RAID, discos e fontes;
Espaço disponível e crescimento dos volumes;
Saúde de hosts e máquinas virtuais;
Falhas de backup e retenção;
Disponibilidade de DNS, Active Directory e banco de dados;
Uso de interfaces de rede, perda de pacotes e latência;
Expiração de certificados, licenças e garantias;
Eventos de autenticação e acessos administrativos.
A própria Microsoft disponibiliza um guia para investigação de problemas de desempenho no Windows Server, baseado na coleta de dados e análise de contadores de desempenho. Isso reforça a importância de medir o ambiente antes de decidir por expansão ou substituição.
O monitoramento de TI ajuda a identificar desvios antes que afetem usuários, sistemas e processos críticos. Para isso, os alertas precisam ter prioridade, responsáveis e um fluxo claro de escalonamento.
Checklist para revisar a resiliência do ambiente
Uma revisão inicial pode começar pelas seguintes perguntas:
A empresa sabe quais sistemas são essenciais para operar?
Há inventário de servidores físicos, máquinas virtuais, aplicações e responsáveis?
As dependências entre sistemas estão documentadas?
CPU, memória, disco, rede e backup são monitorados?
Os servidores possuem atualizações, suporte e capacidade para o crescimento previsto?
Existem pontos únicos de falha conhecidos?
Os backups possuem cópias separadas ou protegidas contra alteração?
As restaurações já foram testadas?
RPO e RTO foram definidos para os serviços mais importantes?
Existe uma sequência documentada de recuperação?
A equipe sabe quem acionar e quais informações registrar durante uma falha?
Mudanças relevantes possuem janela, testes e plano de retorno?
Respostas desconhecidas não significam necessariamente que o ambiente esteja comprometido. Elas mostram onde a análise deve começar e quais riscos precisam ser priorizados.
Resiliência é resultado de rotina, não de uma única ferramenta
Resiliência em infraestrutura não depende de um único servidor, fabricante ou software. Ela é construída pela combinação de diagnóstico, documentação, capacidade adequada, virtualização planejada, backup protegido, testes de recuperação, monitoramento e processos claros.
Quando esses elementos estão organizados, a empresa deixa de agir apenas em situações urgentes. Passa a identificar riscos com antecedência, priorizar investimentos e recuperar serviços importantes com mais segurança.
Para ambientes que dependem de aplicações locais, servidores Windows ou Linux, máquinas virtuais e armazenamento corporativo, essa revisão deve considerar todo o conjunto — infraestrutura física, rede, backup, monitoramento e continuidade. Conheça também a solução de servidores Windows, Linux e virtualização.